用AI做服装展示账号怎么做?一份可落地的运营方案
用「一键换装」这类应用,一张模特图配一张服装图,30-60 秒出一张换装成图。它撑起的是服装展示号:固定一个人物,换不同衣服,稳定更新。下面是可照做的方案。
先说结论
- 服装展示号可以靠"一个固定人物 + 多套服装"撑起来:输入是模特图和服装图各一张,输出是一张换装成图,接口标注耗时 30-60 秒。
- 门槛在素材不在工具:两张图都要干净——人物姿态清楚、服装完整可辨。素材糊,成图跟着糊。
- 公开记录里那张"替换衣物图"本身就是一张已经有人穿着服装的图,不是平铺的衣服照片;想拿真·平铺图直接变模特上身,得自己先跑一次试。
- 换装会保留原图的人物、姿势、背景和配饰——记录里模特脖子上的丝巾在换装后依然在,所以成图必须逐张复核。
- 它只管出图,不管选题和文案。账号能不能起来,还是看定位和排期。
谁在为服装展示发愁?
做服装生意或者做穿搭内容的人,大多会撞上同一堵墙:内容要持续更新,图却越来越难出。
找模特实拍,流程长——约档期、定摄影、租场地、出片、修图,一圈走完以天计,上新节奏一快就跟不上;不拍吧,账号一断更,之前攒的手感和权重都要重新找。还有一类是做穿搭号的个人创作者,人和衣服都在手上,缺的是能稳定出片的产能,最后只能靠库存照片反复发,账号越做越像图库。
「一键换装」这个应用针对的就是这一环。它在智豆AI(zhidou.xin)的应用库里属于服装展示类目,做的事很单一:拿一张模特图当"人",拿一张服装图当"衣服",让图里的人换上传过去的那件衣服。它不做排版、不做文案,只负责把"换装"这一步做完。
哪种出图方式更适合长期更新?
| 做法 | 投入方式 | 多久出一组 | 需要什么基础 | 适合谁 |
|---|---|---|---|---|
| 自己请模特实拍 | 按项目付费 | 从排期到交片通常以天计 | 会找模特、能对接摄影 | 上新量大、坚持要实拍质感的店铺 |
| 购买图库素材 | 订阅授权 | 当场就能下载 | 会挑图、能接受撞图 | 只要配图、不介意同款被复用的人 |
| 固定一人实拍 + 后期修图 | 一次性购置拍摄器材 | 以天计 | 有固定模特资源和后期能力 | 已有拍摄基础、想压缩排期的人 |
| 用「一键换装」生成 | 按需生成 | 30-60 秒 | 一张模特图 + 一张服装图 | 想用同一个人物长期更新的人 |
(数据来源:生成耗时取自应用接口标注的 estimatedTime 字段「30-60秒」;其余周期为行业常见交付节奏的定性说法,不涉及具体金额。)
具体怎么操作?
第一步,先备好两张图。一张模特图,就是你要换装的那个人,建议全身或半身、姿态清楚、背景别太乱;一张替换衣物图,尽量把整件衣服拍清楚,正面、无遮挡、颜色不失真。
你会看到:应用界面里有两个图片上传位,一个标着「模特图」,一个标着「替换衣物图」,两个都是必填项,少一个提交不了。
第二步,看一眼提示词。提示词输入框里已经预填了默认值「让图一的人物穿上图二的衣服」,多数情况直接用它就够了;如果你要指定裙长、颜色倾向或者整体风格,可以在这个基础上补一句话。
你会看到:一个多行文本框,里面躺着那句现成的默认提示词,不填也能跑。
第三步,点生成,等 30-60 秒。
你会看到:一张换装成图。人物还是原图里那个人,姿势、角度、背景基本没动,身上的衣服换成了你上传的那件。
第四步,逐张复核,再排进内容日历。
你会看到:成图可以直接当服装展示素材用。但发之前建议放大看三处——服装的版型对不对得上、有没有多余的配饰残留、手部和领口有没有变形。这一步省不掉,尤其是批量做的时候。
我实际试下来的感受
先说清楚一件事:这一节里的图不是我现场跑的,是我翻看作品中心里这个应用的公开任务记录,把输入和输出对照着看了一遍。目前这个应用只挂出 1 条公开记录,样本不多,但足够看清它的工作方式。
那条记录是这样跑的:一张站着的模特图(人物穿着蓝绿色缎面礼服,站在中式花格窗前,手里拿一把折扇),配一张服装图,提示词就是默认那句「让图一的人物穿上图二的衣服」。
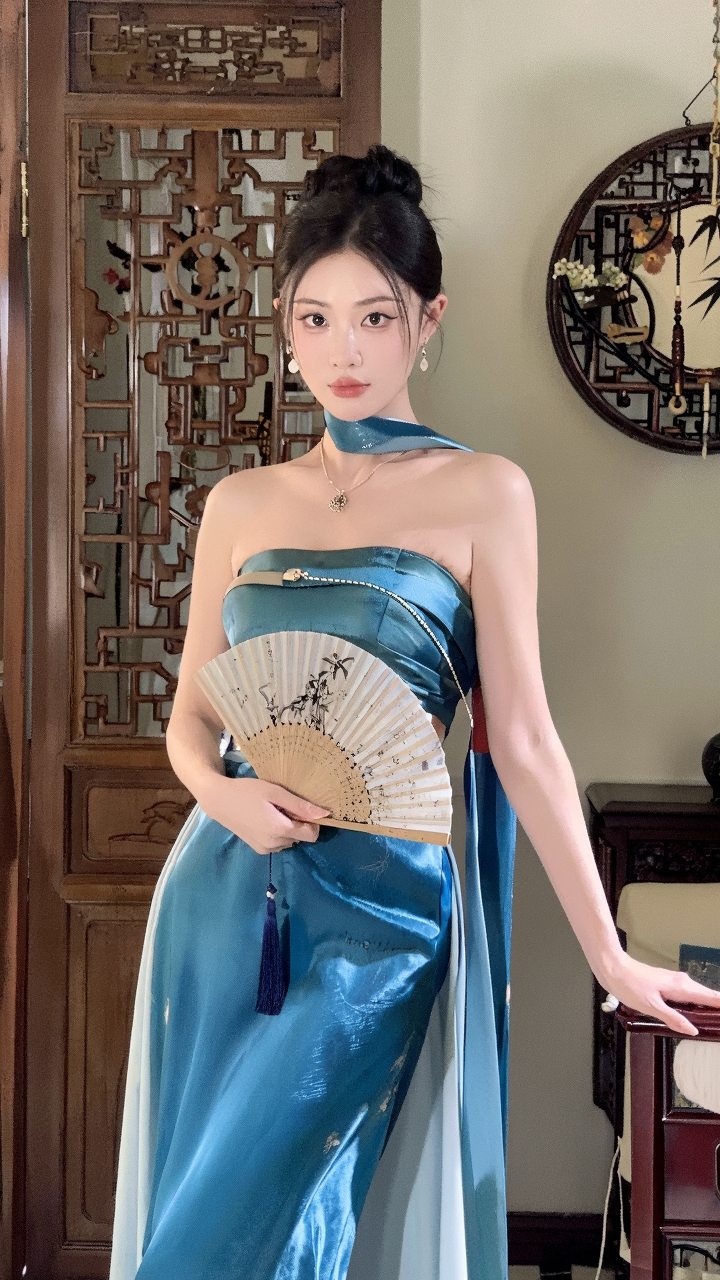
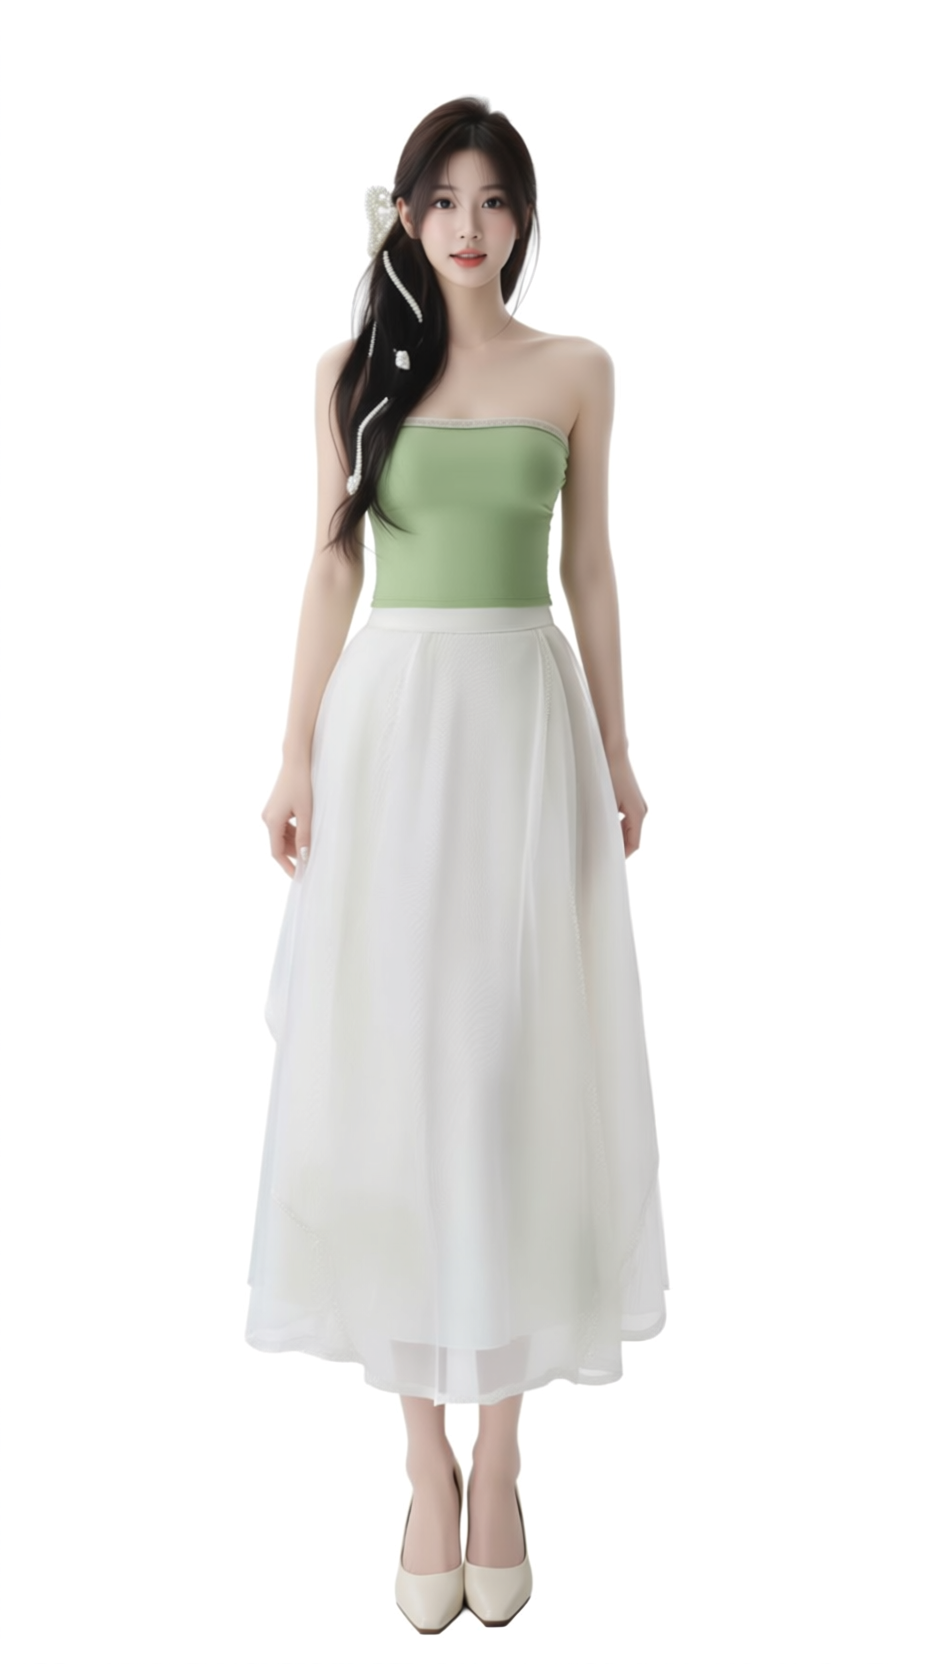
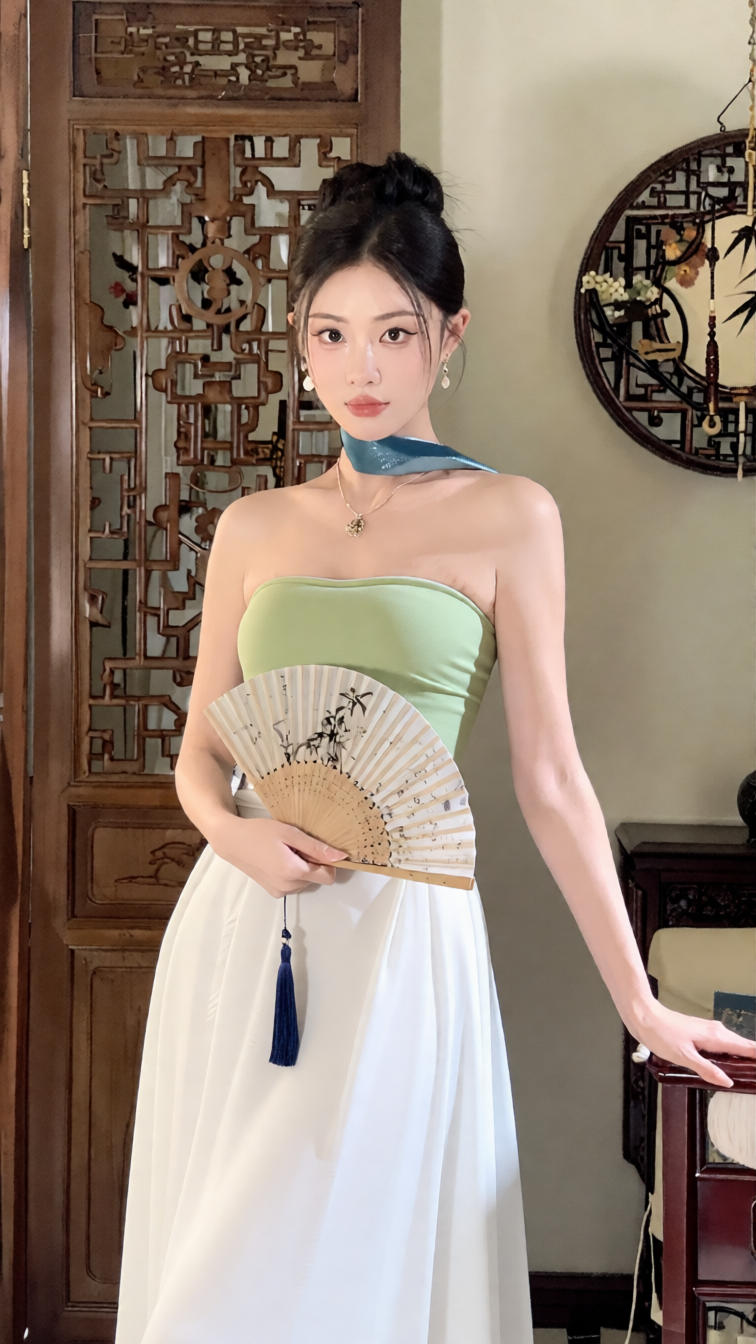
出来的结果是:人物、姿势、角度、背景、手里的折扇全部保留,只有身上的衣服换掉了——礼服变成了第二张图里的那套薄荷绿抹胸上衣配白色长裙。这正好对应接口给它的三个标签:智能换装、服装迁移、超高一致性。
但这个"一致性"里也藏着要留神的地方,至少有四条:
第一,配饰会跟着留下来。原图模特脖子上搭着一条蓝丝巾,换装后那条丝巾还在,和新换的衣服并不是一套。你如果要求整套搭配干净,就得靠提示词去压,或者后期自己擦掉。
第二,记录里那张"替换衣物图"是一张已经有人穿着这件衣服的图,不是平铺的服装照片。也就是说,这条公开记录证明的是"人换衣服",不是"平铺图变模特上身"。你要是想拿真·平铺图当服装图输入,效果得自己先跑一次确认,不要预设它一定行。
第三,样本只有 1 条。30-60 秒是接口标注的时间,实际排队情况会不会拉长,这一条记录说明不了,批量做的时候要把等待时间算进排期。
第四,手部、领口、面料纹理这类细节,放大后仍然要人工过一遍。换装类工具的通病是全身看没问题、局部放大才露馅,所以"生成完直接批量发"这个动作,我建议你放弃。
最后一点也是最容易被忽略的:它只换衣服,不解决拍什么。同一个人的多套服装怎么排、每一套配什么文案,才是账号能不能立住的关键。
常见问题
Q1:没有真人模特,能用AI生成的人像当模特图吗? 接口要求上传的是「模特图」,也就是需要换装的那个人物照片,并没有限定必须实拍。理论上任何一张符合要求的人物图都能当输入,但公开记录里只有实拍人像的案例,AI 人像的效果需要你自己验证一次。
Q2:服装图可以传平铺的商品照片吗? 这一条我不敢替你打包票。公开记录里那张替换衣物图本身就是一张已经有人穿着的服装图,平铺图输入会得到什么结果,记录里给不出依据,建议你先拿一件衣服跑一次再看。
Q3:想做一组九宫格,要跑几次? 一次任务对应"一张模特图 + 一张服装图",输出一张成图。九宫格就是九套衣服分别跑九次。好在模特图可以一直复用同一张,这也是账号视觉统一的关键。
Q4:提示词除了默认那句还能写什么? 默认的「让图一的人物穿上图二的衣服」已经覆盖了主流程。要微调的话,可以在它后面补一句描述,比如强调保持人物面部和背景不变、或者说明服装的穿着方式。不建议把提示词写得过于复杂,反而容易让结果跑偏。
Q5:为什么出来的衣服和原图对不上? 常见的三个原因:服装图本身拍得不清楚或有大面积遮挡;模特图里原本的衣服面积太大、领型差异过大;提示词里混进了互相矛盾的描述。换一张更清楚的服装图、或者把提示词收敛回默认值,通常就能改善。
写在最后
服装展示这件事,卡人的从来不是"有没有好衣服",而是"能不能稳定地出图"。换装工具帮你省掉的只是约模特、排档期那一段,定位、节奏和文案还是得自己定;而"固定一个出镜人物"这件事本身,恰恰是这类账号最值钱的资产——观众记住的是那张脸,不是那件衣服。
如果你想试,可以在智豆AI(zhidou.xin)里找到「一键换装」,先拿一张自己的人物图加一张服装图跑一次,看看换出来的效果能不能接受,再决定要不要按上面这套节奏排下去。
用智豆AI,把上面的思路变成作品 👉
立即去创作