用AI做双人跳舞账号怎么做?一份可落地的运营方案
能做。两张人物照片加一句背景描述,AI 就能生成两人同框、同步跳舞的竖版短视频,不需要真人出镜拍摄,很适合做情侣、闺蜜或搭档类的双人跳舞账号。
先说结论
- 拍不了双人同框的内容,用 AI 合成是一条可行路径:照片各出一张,剩下交给模型。
- 背景可以一句话指定,今天人民广场、明天古镇街景,账号天然自带"打卡"属性。
- 单条视频 10 秒左右、竖版 9:16,直接适配抖音、快手、小红书的推荐流。
- 按次生成、消耗点数,不用添置拍摄设备,起步成本主要在选图和排队等待上。
- 适合两个有默契感的人设(情侣、闺蜜、师徒、搭档),单人账号不建议硬套。
用两张照片能撑起一个账号吗?
可以,但撑起账号的不是"会跳舞"这一个点,而是"双人关系"。单纯一段舞蹈视频,用户看完就划走了;两个人物之间有互动、有故事(情侣合拍异地补偿、闺蜜打卡、亲子同框),才有追更的理由。
我在智豆AI的应用广场翻到了「双人跳舞·Animate V2」的公开任务记录,这套玩法已经有真实产出可以参考:上传两张人物图,模型驱动两人同步起舞,舞蹈风格由模型自动匹配,用户主要控制的是背景描述。
这类账号以前卡在哪?
- 凑不齐人:双人内容要两个人同时到场、同时有空,异地情侣或上班族搭档基本拍不了。
- 跳不齐动作:真人拍双人舞需要排练,动作不齐就被评论区挑刺。
- 场地受限:想在广场、古镇、海边各拍一遍,成本和时间都不允许。
- 剪辑门槛:对拍、卡点、调色,每条视频都要花一两个小时。
AI 合成把这四件事压成了一件事:把两张照片准备好,背景写一句话,等模型生成。
不拍摄和真人拍,两条路怎么选?
| 维度 | AI 双人合成 | 真人实拍 |
|---|---|---|
| 做法 | 上传两张人物图+一句背景描述,生成同步跳舞视频 | 两人到场、排练、实拍、剪辑 |
| 投入方式 | 按次生成(消耗点数) | 时间+场地+设备持续投入 |
| 多久出片 | 单次等待约 5-30 分钟 | 半天到一天 |
| 需要什么基础 | 会选照片、会写一句背景描述 | 舞蹈基础或摄像剪辑能力 |
| 适合谁 | 异地情侣、闺蜜、想批量做号的人 | 有人手、要真实感的团队 |
数据来源:应用接口的输入项与耗时标注(5-30 分钟),以及应用广场 2026 年 6-7 月的公开任务记录(产出为 512×1024 竖版、24fps、约 10 秒视频)。
具体怎么操作?
- 定人设:先想清楚这两个人是谁——情侣、闺蜜还是搭档。人设定了,选照片的方向、背景的调性、配乐的口味都跟着定。这一步你会得到一份一句话账号定位。
- 备照片:两人各选一张正面、光线均匀、姿态自然的单人照,服装风格尽量协调(比如都偏国风、都偏休闲)。你会得到 10-20 对备用照片,够账号跑一个月。
- 写背景描述:参考公开记录里的写法,直接写"背景是中国临沂市人民广场""背景是天安门广场"这样的完整句子。背景越具体,画面的打卡感越强。你会得到一份选题背景清单。
- 提交生成:在应用列表里找到「双人跳舞·Animate V2」,上传两张图、贴入背景描述,提交后等待约 5-30 分钟。你会看到一条 10 秒左右的竖版双人跳舞视频。
- 批量存稿再发布:一次多跑几条,按"城市打卡"系列存着,隔天发一条。你会得到一个能持续两周以上的内容库存。
我实际试下来的感受
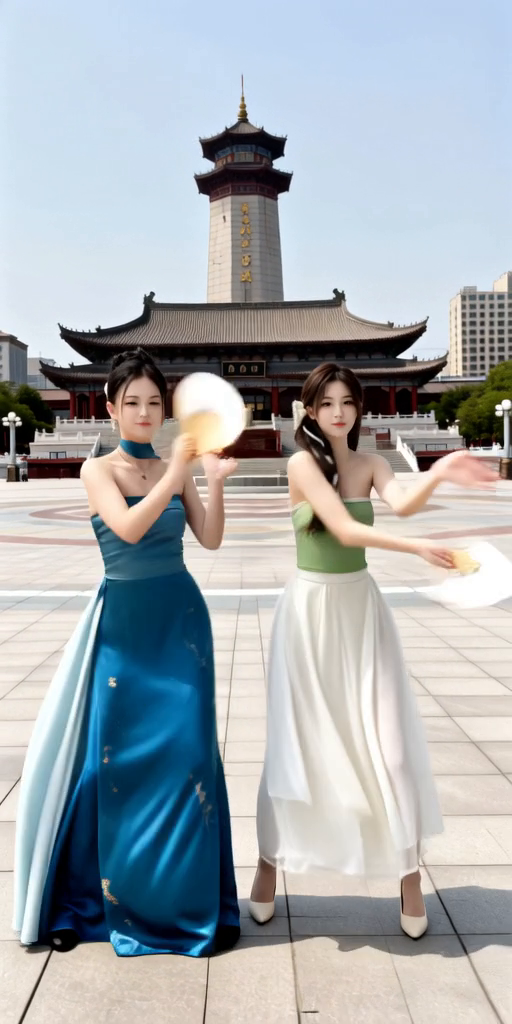
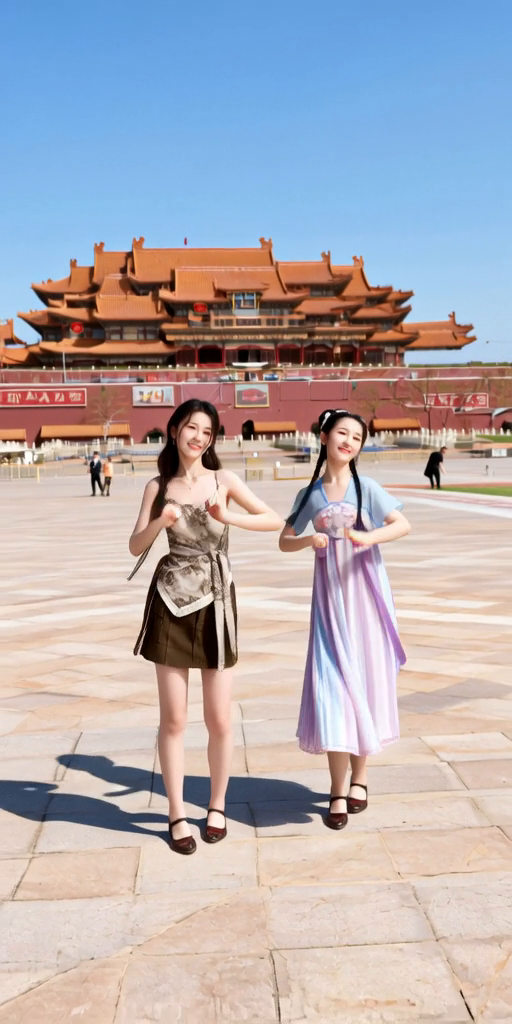
我把作品中心里 2 条真实任务记录从输入到输出完整看了一遍:一条指定临沂市人民广场,两位穿长裙的女生持折扇同步起舞;另一条指定天安门广场,两位女生在开阔的广场上齐舞。两条都是 512×1024 竖版、约 10 秒,动作同步的整体连贯度比我预想的好,背景确实按描述生成了。
也要说局限:公开记录的产出都是 10 秒左右的短条,想出 30 秒以上的完整舞蹈,这个应用目前给不了;分辨率 512 宽度在手机上够看,投大屏就偏弱;从记录看,用户能控制的只有背景描述,舞蹈风格、节奏没有参数可选,生成什么样有一定随机性,得多跑几条挑满意的。另外生成高峰期等待时间会靠近 30 分钟一档,别卡着发布时间才提交。
常见问题
Q1:两个人必须上传真人照片吗? 不必。应用描述写的是"人物/角色图片",动漫角色、虚拟形象也可以,但同一账号里人物风格要统一,混搭会让粉丝记不住你的账号。
Q2:一条视频只有 10 秒,够发吗? 够。抖音和小红书的双人舞蹈类内容里,10 秒上下的短条本来就是主流节奏,关键靠封面和前 2 秒抓住人。想做长内容,可以把多条不同背景的成片剪成合集。
Q3:生成的动作和我上传照片里的姿势一样吗? 不一样。模型是驱动人物去跳舞,照片主要提供人物形象,动作由模型匹配舞蹈风格自动生成,所以同一对照片多跑几次会有不同版本,值得多挑。
Q4:背景描述随便写都能生效吗? 从公开记录看,写"某城市的广场"这类清晰地点,背景还原度比较好;过于抽象的描述(比如"氛围感场景")效果就不好说,建议按"地点+场景"的格式写。
作品中心公开作品
下面这些是作品中心里这个应用的真实公开任务记录,可以直接看效果:
案例 1:上传2张人物图,AI驱动双人同步跳舞
用智豆AI,把上面的思路变成作品 👉
立即去创作